Agent 记忆
在用户、会话、全局三种作用域上 Remember、Recall、Reflect、Consolidate。Recall 返回可直接放进提示词、带出处的上下文包;关系类问题以图边事实作答,比如 Alice —uses→ Apollo。
CortexDB 是一个开源的 Go 库,给 Agent 做记忆。一个文件里装着向量、全文检索、RAG 文档、分作用域的记忆,以及带 SPARQL、推理和校验的 RDF 知识图谱。它就运行在你的程序里,不需要 embedding 模型也能用,MIT 协议。
$ go get github.com/liliang-cn/cortexdb/v2
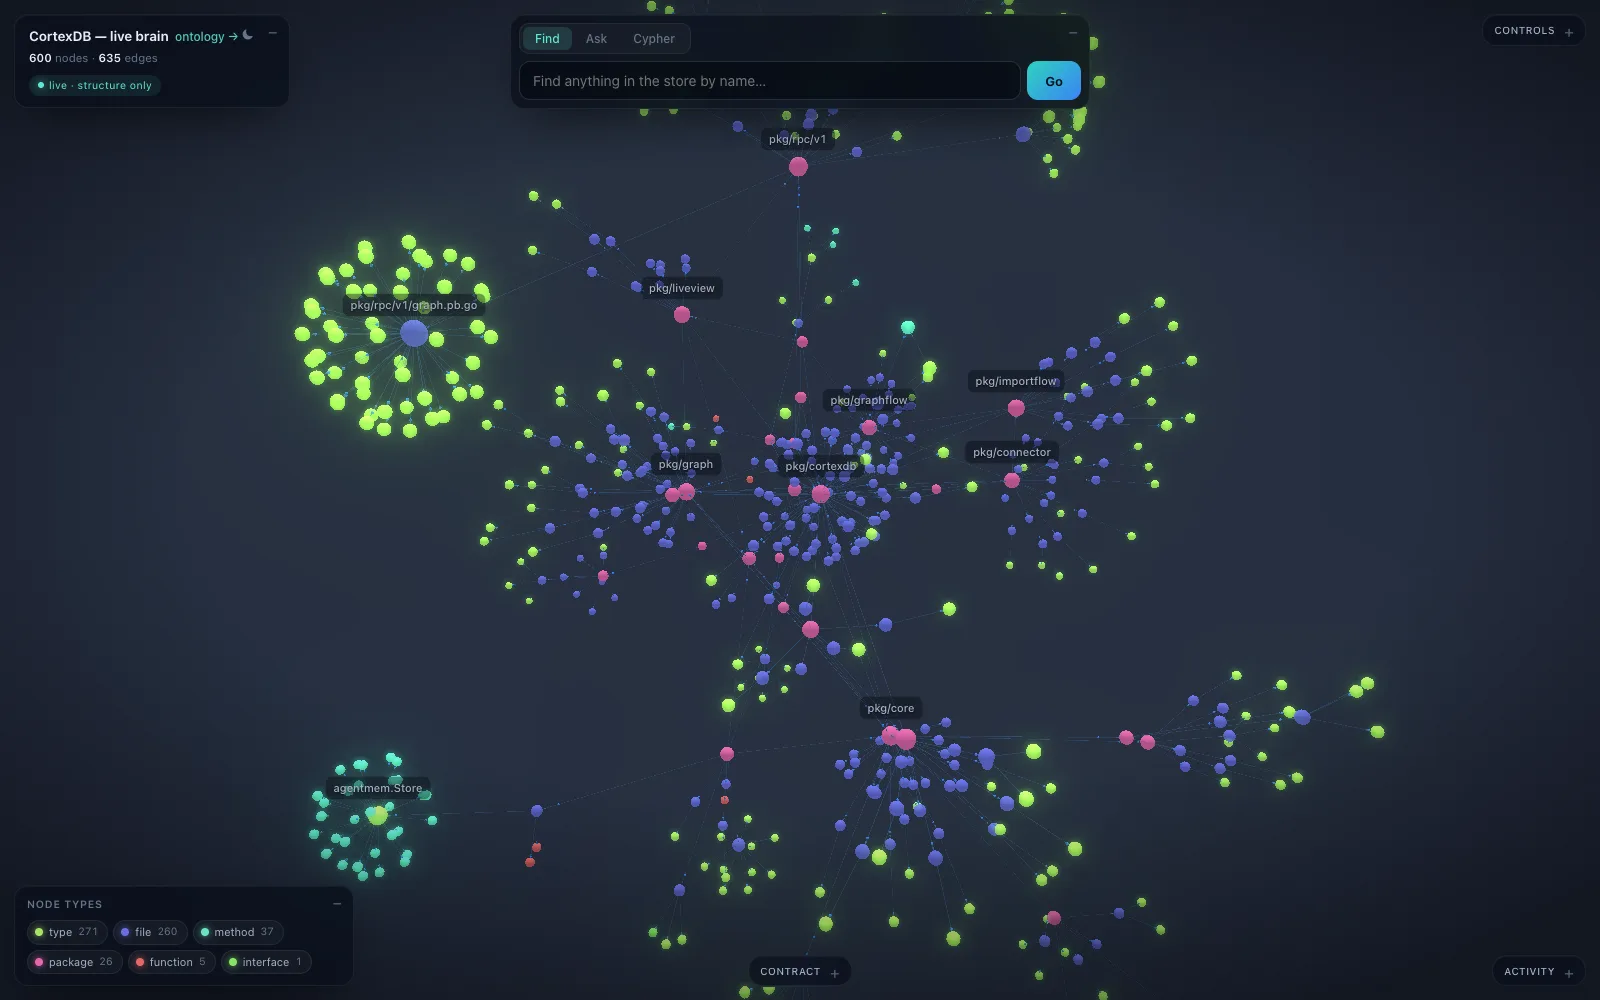
serve_graph_3d 打开 CortexDB 自己的代码图谱:3835 个符号里画出 600 个,其余的一次搜索或展开就能到。功能
不用部署服务,也不用同步第二个数据库:默认 SQLite,一个文件装不下时换 PostgreSQL + pgvector。
在用户、会话、全局三种作用域上 Remember、Recall、Reflect、Consolidate。Recall 返回可直接放进提示词、带出处的上下文包;关系类问题以图边事实作答,比如 Alice —uses→ Apollo。
向量、词法、混合、图四条通道按排名融合,再加上个性化 PageRank(HippoRAG 2),专门对付答案隔了两跳的问题。auto 只在问题点名了具体实体时才走图。
RDF 1.2 三元组项、SPARQL 1.1 与 1.2、只读 Cypher、RDFS 与 OWL 2 RL 子集、SHACL 校验和 SHACL-AF 规则。每条推理出的三元组都能解释来源;矛盾会被报告,绝不靠猜来消解。
每一次已提交的写入,都在同一个事务里写进 change_log:按提交顺序、恰好一次、回滚的写入不留痕。推理结果靠它自动保持最新,同步和触发器也建在它上面。
80 多个工具,进程内和 MCP 上名字一样。插件让 Claude Code 和 Codex 共用一个大脑,带 /remember、/recall 和自动召回钩子;gRPC 服务让多台机器共享它。
CortexDB 不引入任何大模型 SDK。没有 embedder 时走词法检索——整句的中文提问也能召回——并照样建立实体图。接上任意 OpenAI 兼容的 embeddings 端点就有向量检索。
带主键和基数的对象、链接、接口类型,对象集代数,留审计记录的动作类型,以及能发现破坏性变更的 schema diff——Palantir 式本体,同在一个文件里。
HNSW、IVF、Flat 索引,标量和乘积量化,以及先用 1 比特编码筛选、再精确重排的二值量化:在真实的 768 维 embedding 上 recall@10 为 0.979–0.996,内存只要 1/32。
每条记录都可以带上来源、分块、生产者和可信等级——已核实、仅断言、已拒绝。Authorize 回调把关每一个检索候选,权限控制落在检索层。
快速开始
嵌进 Go 程序,给编码 Agent 加上记忆,或者跑一个服务让多个客户端共享。
打开文件,记住,召回。不需要 embedder。
db, _ := cortexdb.Open(cortexdb.DefaultConfig("brain.db"))
defer db.Close()
brain := db.KnowledgeMemory()

brain.Remember(ctx, cortexdb.KnowledgeMemoryRememberRequest{
    Content: "Alice 喜欢用 tab 缩进。", Scope: "user",
})
rec, _ := brain.Recall(ctx, cortexdb.KnowledgeMemoryRecallRequest{
    Query: "Alice 喜欢什么缩进?",
})
fmt.Println(rec.ContextPack.Text) // 带出处一个全局大脑、斜杠命令和自动召回,无需 API key。
# Claude Code
/plugin marketplace add liliang-cn/cortexdb
/plugin install cortexdb@cortexdb

# Codex
codex plugin marketplace add liliang-cn/cortexdb
codex plugin add cortexdb@cortexdb

# 之后在任何会话里
/remember 预发数据库在 45432 端口
/recall 预发数据库跑一次 gRPC 服务,客户端和 Agent 都连它。
go install github.com/liliang-cn/cortexdb/v2/cmd/cortexdb-grpc@latest

# 类型化客户端
cargo add cortexdb-client
pip install cortexdb-client
npm install cortexdb-client

# 多台机器共享一个大脑
export CORTEXDB_REMOTE=host:port
评测
标准检索评测走的是应用实际调用的同一套公开 API——先 SaveKnowledge,再 SearchKnowledge——用 cortexdb-bench 跑。不接 embedder;auto 是默认模式。
| 评测集 | 类型 | 词法 | Auto | Auto 对比词法 | p95 |
|---|---|---|---|---|---|
| 2WikiMultiHopQA | 多跳 | 0.657 | 0.807 | 21 ms | |
| MuSiQue | 多跳 | 0.457 | 0.542 | 28 ms | |
| LoCoMo | 对话 | 0.493 | 0.495 | 8 ms | |
| LongMemEval | 对话 | 0.861 | 0.862 | 15 ms |
多跳提升来自在 SaveKnowledge 建立的实体图上做个性化 PageRank 游走;在单跳的对话记忆上,auto 保持词法的召回,因为大多数段落都提到的实体(比如对话里的说话人)不会被用作游走起点。数据集用 sha256 固定;用 go run ./cmd/cortexdb-bench 复现。
看得见
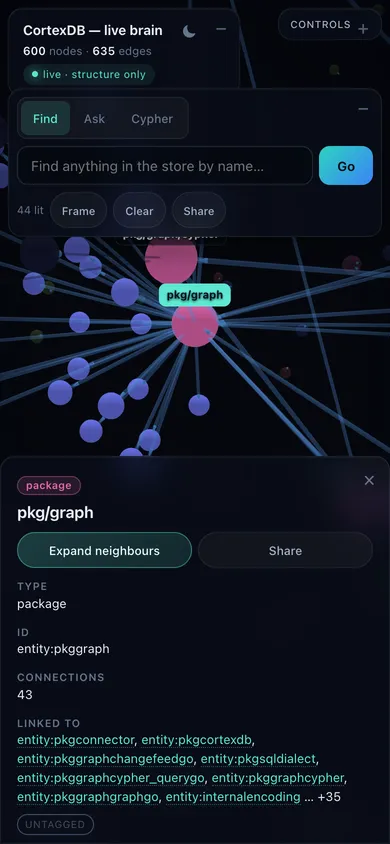
CortexDB 生来可检查。serve_graph_3d 直接从处理调用的 MCP 服务里提供实时视图,Agent 碰到哪里,图就在哪里亮起来。可以在整个库里查找任意节点、直接提问、跑只读 Cypher,再一个节点一个节点地展开。graph_schema 报告数据实际呈现的 schema,每条推理出的事实都能追溯到它所依据的事实。
?focus=、?ask=、?cypher=、?theme=sqlite3 打开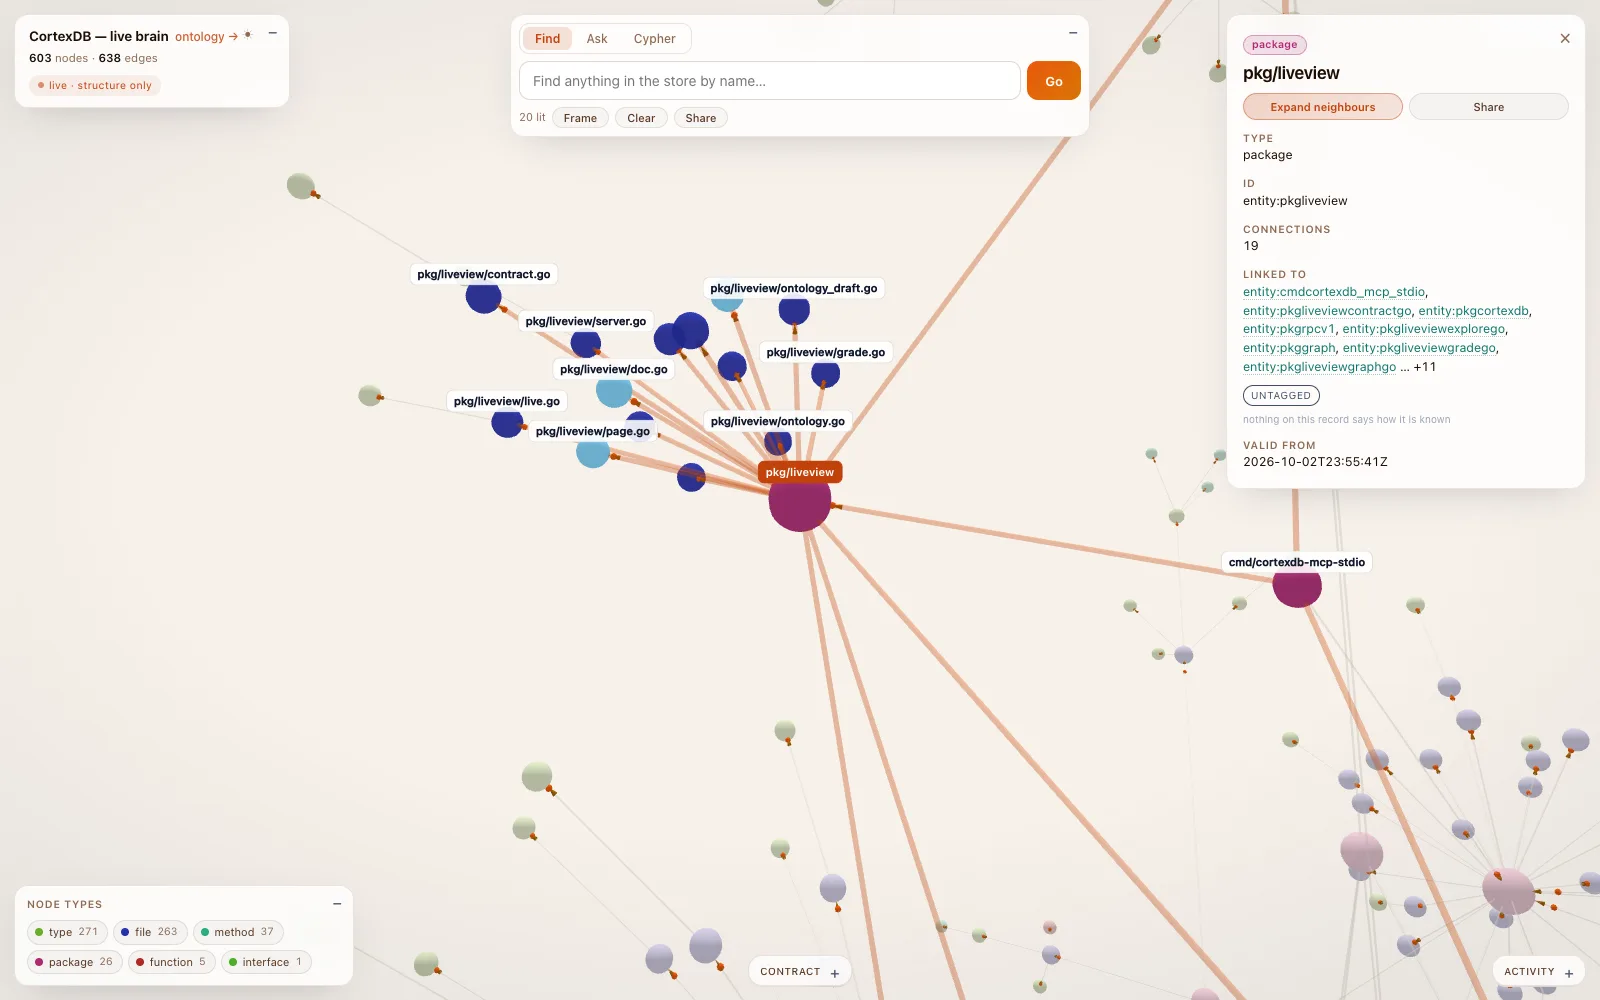
适用场景
常见问题
CortexDB 是一个开源 Go 库,把 AI Agent 的记忆和知识存进一个 SQLite 文件:向量、全文检索、RAG 文档、分作用域的记忆,以及可以用 SPARQL 或只读 Cypher 查询的 RDF 知识图谱。它运行在你的程序里,不需要单独部署服务,采用 MIT 协议。
不需要。CortexDB 不引入任何大模型 SDK。没有 embedder 时使用词法检索(FTS5,中文、日文整句提问都能召回),并照样建立实体图供图游走检索使用。接入任意 OpenAI 兼容的 embeddings 端点(例如 Ollama)即可启用向量和混合检索。
向量数据库存 embedding、回答最近邻查询。CortexDB 是嵌入式库,除了向量,还管理分作用域的 Agent 记忆、RAG 文档,以及带推理和校验的知识图谱,全部在代码旁边的一个文件里。它不是分布式向量数据库,也不是企业级 RDF 服务器。
可以。cortexdb-grpc 服务端通过 gRPC 提供同一个大脑,并有 Rust(cargo add cortexdb-client)、Python(pip install cortexdb-client)和 Node.js(npm install cortexdb-client)的类型化客户端。Agent 也可以通过它的 MCP 服务端使用。
能。它为两者都提供插件。在 Claude Code 中运行 /plugin marketplace add liliang-cn/cortexdb,再运行 /plugin install cortexdb@cortexdb。插件默认词法模式,无需 API key,在 ~/.cortexdb/cortexdb.db 保存一个全局大脑;多台机器指向同一个 cortexdb-grpc 服务即可共享。
默认 SQLite,使用纯 Go 的 modernc.org/sqlite 驱动,因此没有 CGO。用 postgres:// 连接串即可把同一个大脑搬到 PostgreSQL + pgvector;向量、混合检索、记忆和 RDF 图在两者上行为一致。
SPARQL 1.1(有文档说明的实用子集)及 SPARQL 1.2 三元组项,属性图上的只读 Cypher,随事实变化自动保持最新的 RDFS 与 OWL 2 RL 子集推理,SHACL 校验和 SHACL-AF 三元组规则。范围内的 W3C RDF 1.2 与 SPARQL 1.2 测试集在 SQLite 和 PostgreSQL 上均通过。
用 cortexdb-bench 经公开 API 实测,不接 embedder,默认 auto 模式与纯词法检索的 recall@5 对比:2WikiMultiHopQA 0.807 对 0.657,MuSiQue 0.542 对 0.457,LoCoMo 0.495 对 0.493,LongMemEval 0.862 对 0.861,p95 延迟低于 30 毫秒。多跳问题的提升来自在实体图上做的个性化 PageRank 游走。
MIT 协议开源。一条命令加进 Go 模块。